本文定位:面向开发者的工程实践——代理池架构、失败分类、动态住宅 IP 的 API 集成与"死节点"自动剔除。示例代码仅用于你已获准访问的目标(站点明确提供的接口、或已获授权的站点);代理池负责出口分配、有效期管理与故障隔离,它不提供访问授权,也不保证降低质询频率。文末附完整可运行的参考实现(含端到端演示入口)与 18 项验收测试。
先说结论:轮换的前提是分清故障类型
简短回答:高并发下的代理轮换,核心不是"换 IP 换得快",而是四件事——集中管理供应商 API(完整快照语义:续期、回收、格式校验)、固定数量的工作线程配上有独立容量的任务队列(队列缓冲容量固定,生产入队受背压;注意输入列表与结果字典仍随任务数占用内存)、失败分类(403/429/407/目标 5xx 都不是节点死亡,无法归因的异常不计入节点状态,只有代理连接层异常才记可疑)、以及半开复检式的"死节点剔除"——关键设计是区分反馈来源:普通业务请求的模糊网络异常只能触发冷却(目标持续缓慢不应导致正常代理被移除),只有独立复检函数(使用自有或获准的健康检查目标,不是普通业务请求)的确认失败才推进移除轮数;复检结果分三种去向(成功恢复、确认失败进下一轮、无法归因回到冷却择期再试);旧一轮在途请求的反馈不推进新状态。把所有异常都当死节点删掉,你会把好节点删光、把目标站的问题误诊为代理问题。
先分清两种供应商模式
写代码之前先确认你的供应商是哪种模式,两者的管理逻辑完全不同:
| 模式 | 形态 | 客户端要管什么 |
|---|---|---|
| API 返回代理地址列表 | 每次调用 API 拿到一批 host:port(带有效期) |
地址、凭证、有效期、健康状态全归你管 |
| 固定轮换网关 | 网关地址不变,出口由供应商侧轮换或会话保持 | 只管网关地址与认证;出口轮换规则看供应商定义 |
注意三个不是同一件事的操作:换网关地址 ≠ 换出口 IP ≠ 换业务会话。本文的代理池代码针对第一种模式(API 返回地址列表)——这也是"死节点剔除"话题的主要场景。游览目标站策略问题时,可内链参考上一篇 《如何轻松突破 Cloudflare 5秒盾与 Turnstile 人机验证》。
代理池架构:一个状态闭环
整体架构分四层,失败分类器的反馈形成闭环:
供应商适配器(API 刷新,集中管理,完整快照)
        │  同 URL 续期 / 不再返回的地址出池 / 格式校验
        ▼
带有效期的代理池(线程安全)
   可用 ──失败──▶ 冷却 ──到点──▶ 待复检 ──单次探测──▶ 复检在途
                                                        │成功/失败
   可用 ◀───────────────────────────────────────────────┘
        ▲
        └──── 失败分类器反馈(旧 epoch 忽略)────┐
        │                                        │
        ▼                                        │
固定工作线程 + 有界任务队列 ──▶ 获准目标 ◀──────┘
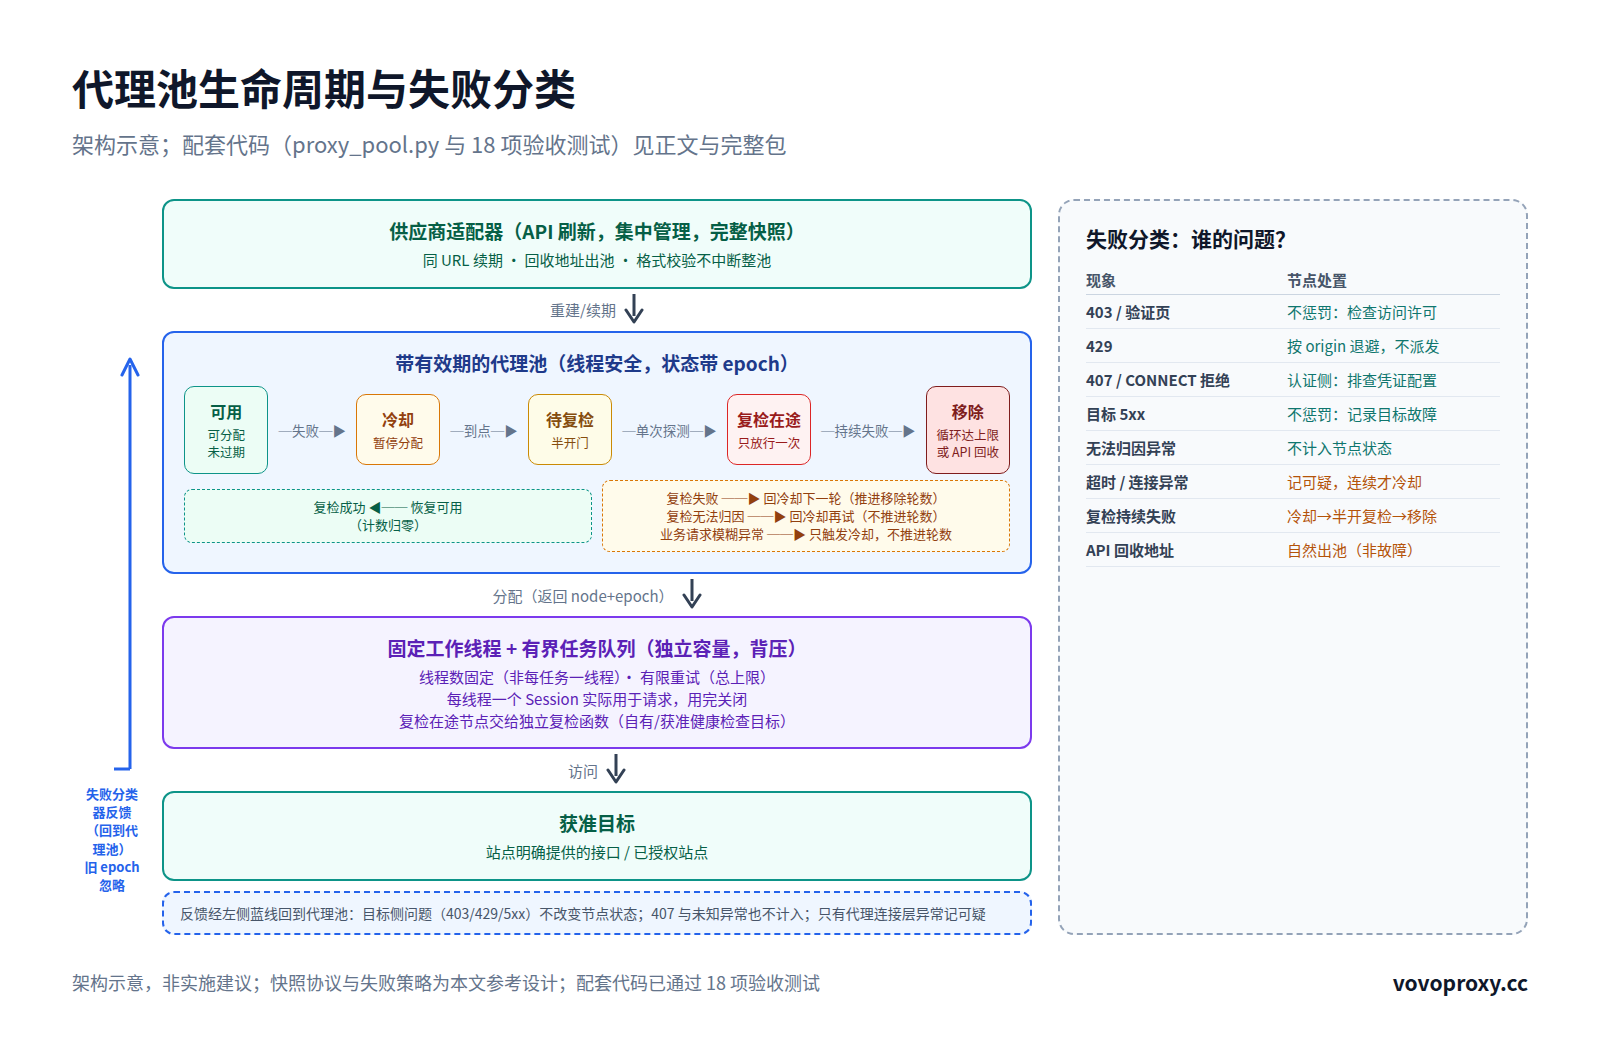
"死节点剔除"的正确定义(分两层):暂停分配(冷却)→ 到点转为待复检(半开门)→ 只放行一次探测(复检在途状态,其他线程拿不到它)→ 复检结果分三种去向:成功恢复可用(计数归零)、确认失败进入下一轮冷却或移除、无法归因(403/429/认证/目标 5xx/未知错误)回到冷却择期再试、不推进轮数。反馈来源决定效力:普通业务请求的模糊网络异常(包括读取超时这类无法明确归因的异常)只能触发冷却;只有独立复检函数的确认失败才推进移除轮数——复检应使用自有或获准的健康检查目标,而不是拿普通业务请求冒充体检。不是一次失败永久删除,也不是到点直接恢复全员可用——没有受控复检的"自动恢复",等于把坏节点周期性放回生产。
旧反馈隔离:节点状态变更时代数(epoch)递增,在途请求拿着旧代数回报的结果会被忽略——否则一个已经冷却的节点的迟到失败报告,会错误地推进它下一轮的状态。
失败分类:全文最重要的一张表
目标站的策略问题,不能据此判节点死亡,也不应自动换 IP 突破限制:
| 现象 | 处理原则 |
|---|---|
| 目标 403 / 验证页 | 不判节点死亡。检查你的访问许可与目标策略;不自动换 IP 冲破限制 |
| 429 | 目标级退避:记入协调表,退避期内不再向该目标派发(不靠轮换继续突破配额) |
| 407 | 代理认证问题(不是目标侧):排查凭证配置;也不当普通超时无限重试 |
| 目标 5xx | 记录目标侧故障;不惩罚节点 |
| 超时 / 连接异常 | 先记可疑;只有明确的代理连接层异常归此类 |
| 无法归因的异常 | 单独返回,不计入节点状态(配置错误、证书错误、程序错误)——重复出现应人工排查,不是删节点 |
| API 回收地址 / 复检持续失败 | 自然出池(非故障)/ 冷却-复检循环达到上限后移除 |
对应的分类函数(参考实现节选,按类型判断、不用类名字符串猜):
def classify_response(status_code: int, challenge: bool = False) -> Outcome:
    if challenge:                       # 明确质询标志(如 cf-mitigated 头)
        return Outcome.TARGET_REJECTED
    if status_code == 403:
        return Outcome.TARGET_REJECTED  # 目标策略:不惩罚节点
    if status_code == 429:
        return Outcome.RATE_LIMITED     # 目标级退避
    if status_code == 407:
        return Outcome.AUTH_FAILED       # 代理认证:排查配置
    if 500 <= status_code < 600:
        return Outcome.TARGET_ERROR      # 目标故障:不惩罚节点
    if 200 <= status_code < 400:
        return Outcome.OK
return Outcome.TARGET_REJECTED # 其余 4xx 默认视为目标策略异常侧的原则——不要写 except RequestException: 删除代理:
def classify_request_exception(exc: Exception) -> Outcome:
    # 按 requests 的异常类型归因(SSLError 继承自 ConnectionError,先判细分)
    if isinstance(exc, (requests.exceptions.InvalidURL,
                        requests.exceptions.InvalidSchema,
                        requests.exceptions.MissingSchema)):
        return Outcome.UNKNOWN_ERROR     # 配置错误:不计入节点状态
    if isinstance(exc, requests.exceptions.SSLError):
        return Outcome.UNKNOWN_ERROR     # 证书问题:单独排查
    if isinstance(exc, requests.exceptions.ProxyError):
        if "407" in str(exc):
            return Outcome.AUTH_FAILED   # CONNECT 认证拒绝:排查凭证
        return Outcome.NODE_SUSPECT      # 代理连接层:记一次可疑
    if isinstance(exc, (requests.exceptions.ConnectTimeout,
                        requests.exceptions.ConnectionError,
                        requests.exceptions.ReadTimeout)):
        return Outcome.NODE_SUSPECT      # 连接层:记一次可疑
return Outcome.UNKNOWN_ERROR # 未知异常:不猜,交人工分类两个容易误判的点:407 是代理认证问题,不是目标侧问题——HTTPS 经代理的 CONNECT
阶段被拒时还可能以异常形式出现,要按认证问题排查凭证,而不是当普通超时重试;验证页识别需要明确的标志(参考实现只检测
cf-mitigated: challenge 这一种响应头,其他站点的验证页标志各不相同,示例不覆盖通用识别)。如果数据传输遇到频繁掉线问题,可扩展阅读 《为什么普通代理总是频繁断线?》。
Requests 主示例
代理配置的三个官方要点
Requests 官方文档对代理配置有三点值得注意:
- 代理 URL 必须带 scheme。访问
https://目标经 HTTP 代理时,走的是 CONNECT 隧道——proxies字典的https键指向的是代理自身的http://地址:proxies = { "http": "http://10.10.1.10:3128", "https": "http://10.10.1.10:3128", # 代理是 http,目标可以是 https } session.proxies可能被环境变量代理覆盖。官方文档明确:环境代理存在时,session.proxies的值可能被urllib.request.getproxies()的结果覆盖——要确保使用代理,在每次请求上显式传proxies参数(Requests 文档);- Session 提供连接池与 Cookie 保持(Requests API 文档)——每个工作线程一个
Session、用完关闭(
try/finally),比每次请求新建连接高效得多。
请求适配器:返回四元组,只捕请求层异常
参考实现中的 requests 适配(已运行验证,含故障代理冒烟):
import requests

def do_request(job_url: str, proxy_url: str, session) -> tuple:
    # session 由工作线程传入并实际用于请求(每线程连接复用)
    try:
        resp = session.get(job_url,
                           proxies={"http": proxy_url, "https": proxy_url},
                           timeout=10.0)
        challenge = resp.headers.get("cf-mitigated") == "challenge"
        retry_after = None
        if resp.status_code == 429:
            ra = resp.headers.get("Retry-After")
            if ra and ra.strip().isdigit():
                retry_after = float(ra)            # 只解析整数秒形式
                # HTTP-date 形式的 Retry-After 未处理,按需扩展
        return resp.status_code, None, challenge, retry_after
    except requests.RequestException as exc:
return None, exc, False, None # 只捕请求层;程序错误不吞要点:verify 保持默认 True(不关闭 TLS 验证);代理认证按 Requests 文档写在代理 URL 里(http://user:pass@host:port/)——注意
session.auth 是目标服务器的 HTTP 认证,不是代理认证,别配错位置;参考实现的测试验证了凭证只出现在发给代理的
Proxy-Authorization 头里、不会发给目标。凭证管理(从哪里安全地读取)是接入步骤,示例未包含。自由配置代理套件时,亦可延伸阅读 《国内高隐蔽专线是如何绕过 DPI 的?》。
供应商 API 适配器:完整快照语义
参考实现包含一个本地演示 HTTP API(serve_demo_api:起本地服务返回固定 JSON
快照)和实际调用它的适配器(演示接口,不对应任何真实供应商;真实场景把 endpoint 换成你的供应商 API
地址,认证按其文档接入——凭证管理是接入步骤,示例未包含):
class DemoProviderAPI:
    """演示版:真实替换点是 endpoint 与认证方式(按供应商文档)。"""

    def fetch(self, timeout: float = 10.0) -> list[tuple[str, float]]:
        resp = requests.get(self.endpoint, timeout=timeout)
        resp.raise_for_status()
        data = resp.json()                    # 演示格式:完整快照 JSON 数组
        if not isinstance(data, list):
            raise ValueError("响应应为 JSON 数组(完整快照)")
        entries = []
        for item in data:                      # 校验每项,格式非法跳过
            if not isinstance(item, dict):
                continue
            url = item.get("url")
            expires_at = item.get("expires_at")
            if not isinstance(url, str) or not url:
                continue
            if not isinstance(expires_at, (int, float)) or expires_at < 0:
                continue
            entries.append((url, float(expires_at)))
        return entries                          # [(url, expires_at), ...]
refresh() 按完整快照处理(快照协议是本文的参考设计;真实供应商是快照还是增量提取,以其文档为准):
pool.refresh(api.fetch())
# 同 URL 再次返回:续期(更新 expires_at,保留状态)
# 不再返回:地址已回收,直接出池(不是故障)
# 格式非法 / TTL 非法 / 重复 URL:跳过或去重,不中断整池
固定工作线程 + 有界任务队列 + 有限重试
run_jobs 的并发模型:固定 max_workers 个工作线程 +
有独立容量的任务队列(先启动消费者再生产,队列满时生产端阻塞形成背压——注意这是队列缓冲的固定,输入列表与结果字典仍随任务数占用内存,需要流式处理时由调用方改造;不是每个任务一个线程);每个任务的重试有总上限;429
走目标级退避表,按 URL 的
origin(scheme://host[:port])记账——同站不同路径共享退避,其他站不受影响;退避时长优先用响应的
Retry-After 头,没有则用可配置的默认值(演示默认 30 秒,按你的目标要求配置):
results = run_jobs(pool, jobs, do_request,
                   probe_fn=probe,      # 独立复检函数(自有/获准健康检查目标)
                   max_workers=8,      # 固定线程数
                   max_retries=2,      # 每任务重试总上限(1 次初始 + 2 次重试)
                   queue_capacity=16)  # 独立队列容量(背压)
# 结果按任务下标保存:重复 URL 的任务互不覆盖
# 复检在途的节点只交给 probe_fn;业务请求的模糊异常只触发冷却
# 403 → "target-rejected(检查访问许可,不自动换IP突破)"
# 429 → "rate-limited(按目标要求退避)",同 origin 退避期内不再派发
probe_fn(proxy_url, session) 返回与 do_request 相同的四元组,但参数不同(没有
job_url——复检目标是你固定的健康检查地址,不是业务任务)。复检的目的是回答"这个代理还能不能正常转发",而不是"目标站欢不欢迎我"。一个最小的定义:
def probe(proxy_url, session):
    # 复检目标:你自己的健康检查地址(或已获准的检查地址)
    return do_request("http://your-health-check.example/ok", proxy_url, session)
未提供 probe_fn 时,复检视为无结论(回冷却择期再试),不冒充复检结果。
会话关联的任务要单独处理:登录、Cookie、CSRF 等有关联的流程应保持一致的业务会话策略——换代理会换出口,但业务会话的连续性由你的会话管理层负责,不要靠轮换重放。
Selenium 接入:注意会话切换成本
Selenium 里代理通过 Proxy 类配置:先构造 Proxy 对象、逐项设置字段,再挂到浏览器选项上(Selenium 驱动会话文档);下面的构造方式已在本机验证,未启动浏览器):
from selenium import webdriver
from selenium.webdriver.common.proxy import Proxy, ProxyType

proxy = Proxy()
proxy.proxyType = ProxyType.MANUAL      # 手动代理模式
proxy.http_proxy = "myproxy.com:8080"
proxy.ssl_proxy = "myproxy.com:8080"

options = webdriver.ChromeOptions()
options.proxy = proxy
driver = webdriver.Chrome(options=options)
try:
    driver.get("https://example.org")    # 业务操作
finally:
    driver.quit()                         # 异常清理也要 quit()
三个工程提醒:
- 浏览器会话的切换成本远高于 requests——起一个浏览器实例是秒级操作,"每个请求换一个代理"在浏览器场景不现实,合理的粒度是"每个任务/每个账号环境";
- 代理认证因浏览器而异:不同浏览器对代理用户名密码的支持方式不同(有的不支持把凭证直接塞进代理地址),以你所用浏览器的官方文档为准;
- 不要假设能逐请求换代理:如果业务需要多个出口,按实例粒度组织,而不是在既有会话里热切换。
Playwright 接入:按上下文隔离
Playwright 官方文档提供两级代理配置——全局(浏览器启动时)或按上下文。两个独立示例(构造方式已在本机验证:launch、new_context、close 均通过):
# 示例一:全局代理(整个浏览器,含认证字段)
browser = p.chromium.launch(proxy={
    "server": "http://myproxy.com:3128",
    "username": "usr",
    "password": "pwd",
})
try:
    page = browser.new_page()
finally:
    browser.close()
# 示例二:按上下文(browser 已另行启动)
context = browser.new_context(proxy={
"server": "http://myproxy.com:3128",
"username": "usr", # 上下文级代理同样支持认证
"password": "pwd",
})
try:
page = context.new_page()
finally:
context.close()代理参数支持 HTTP 与 SOCKS 代理,server 支持 http://、socks5:// 等形式(Playwright API
文档)。上下文(context)是天然的隔离单位:每个上下文独立的代理、存储与页面,用完即关。注意:关闭 context
只释放本地资源,不等于释放供应商侧的租约、会话或配额——动态住宅 IP 的会话保持参数(如有)以供应商文档为准。
测试与验收清单
参考实现附带 18
项验收测试(python3 test_proxy_pool.py,已运行通过);模块自带端到端演示(python3 proxy_pool.py,使用本地夹具跑通"演示
API → 中继代理 → 目标"全链路):
- 分类函数(407 归认证侧、ProxyError 带 407 归认证、SSLError 等细分类型先判、未知异常不计节点状态);
- 空池正常收尾、格式异常条目跳过、重复去重(后项覆盖)、过期节点不分配;
- 快照续期(同 URL 更新有效期)与回收出池;
- 本地演示 API 全路径:正常快照、空快照、格式异常、续期(适配器真实发起 HTTP 调用);
- 确定性好坏节点混用(确定性选择函数,无随机断言);
- 半开复检:冷却到点只放行一次探测、探测期间不再放行;默认阈值(3)下的完整路径(三次业务可疑进冷却、复检失败进下一轮、复检成功恢复);复检遇无法归因结果回到冷却(不推进轮数);
- 业务/复检来源区分:普通业务失败只冷却(
cycles不推进)、重复的业务来源可疑反馈不推进移除轮数;只有受控复检失败推进移除轮数;run_jobs集成probe_fn(复检在途节点交给独立复检函数、复检通过后继续业务请求、无probe_fn时不冒充复检结果); - 旧 epoch 反馈忽略(在途请求的迟到结果不推进新一轮状态);
- 复检持续失败移除;成功后 cycles/fail_count 归零(间隔很久的失败不累计);
- 403/429/407/5xx/未知错误不判节点死亡;
- 429 按 origin 退避(同站不同路径都退避、其他站不受影响);
- 重试总上限(1 次初始 + 2 次重试 = 3 次后放弃);
- 有界并发 + 独立队列容量(峰值并发 ≤ max_workers,容量 4 跑 20 个任务全部完成,结果按下标保存不互相覆盖);
- 真实 requests 路径:中继代理真实转发(目标收到预期路径,不是代理自己应答)、工作线程 Session
生命周期(每线程一个、复用、结束关闭——经
run_jobs验证)、代理凭证只发给代理(目标收不到Proxy-Authorization)、本地 CONNECT 407 代理明确断言认证失败归因、死代理(连接拒绝 → 可疑)。429/403 的分类由分类单元与模拟请求测试覆盖。
已运行验证:18 项验收测试(覆盖分类、快照、状态机、并发与集成路径)、模块端到端演示、requests
适配器的本地夹具路径(转发/凭证隔离/407/死代理)、Selenium Proxy 构造、Playwright Python
片段(launch、new_context、close 以 Python
版运行通过)。按官方文档编写、仅验证了构造:Selenium/Playwright
的浏览器业务操作片段(导航等)。未包含(接入步骤):真实供应商 API 对接与认证、凭证管理、HTTP-date 形式的 Retry-After
解析。需要真实供应商参数的部分(API 地址、响应格式、TTL、提取频率)在代码中标注为演示接口,不冒充任何真实服务。
常见问题 FAQ
Q:为什么不能把所有异常都算死节点?
A:403/验证页是目标站策略(检查你的访问许可),429 是配额(按 origin 退避),407 是代理认证配置,5xx
是目标故障,无法归因的异常可能是你自己的配置或程序错误——这些删节点都解决不了。只有明确的代理连接层异常才记可疑;且普通业务请求的模糊异常只能触发冷却,移除需要独立复检函数多轮"冷却-复检"的持续失败证据,不是累计业务异常。
Q:代理地址有效,是不是出口就长期固定?
A:不是。动态住宅 IP 的地址通常有 TTL,到期由供应商回收;"地址还在池里"和"出口质量没变"是两回事——健康状态要靠失败分类持续维护,而不是一次体检管永远。
Q:高并发下怎么避免重试放大?
A:三道闸:固定线程数配有界队列(线程总量有界)、重试有总上限(不递归)、目标侧问题不重试(403/429 直接进入对应处理,不自动换 IP
冲)。否则一个目标的临时故障会被重试放大成对代理池的清洗风暴。
Q:urllib3 的 Retry 能不能用?
A:可以但要明确边界——urllib3 Retry 的配置项包括 connect/read/redirect 次数,以及
status_forcelist(哪些状态码触发重试)和 allowed_methods(哪些方法允许重试)等;它管的是传输层,不知道"403
该不该重试"这种业务语义。本文的做法是分类放在业务层、不另配第二套传输层自动重试(避免两套重试叠加放大);如果你要配,按官方文档核对配置项。
总结
高并发代理轮换的工程答案,浓缩为四条:
- 先分清故障类型与反馈来源:403/429/5xx 是目标侧、407 是认证侧、未知异常不计入——都不判节点死亡;只有代理连接层异常记可疑,且业务异常只触发冷却,独立复检函数的持续失败才是移除依据(移除策略是本文参考设计;代理参数、认证与 Session 行为见 Requests 文档);
- 集中管理 + 完整快照:API 刷新集中做、同 URL 续期、回收地址出池、格式校验不中断整池(快照协议与失败策略是本文参考设计,按你的供应商文档核对);
- 受控并发:固定工作线程配独立容量队列(背压)、重试有上限、空池正常收尾、429 按 origin 走目标级退避并优先处理 Retry-After(Python queue 文档);
- 浏览器场景按上下文组织:Selenium 注意会话切换成本与认证差异(Selenium 文档),Playwright 用 context 隔离、用完即关(Playwright 文档)。
如果你的采集业务需要评估多出口网络环境,可以了解 VoVoProxy(以上为官网宣传信息,具体能力建议以实际咨询和测试为准),或直接通过 Telegram:@Tomhox、SafeW:@Tomhox 咨询——沟通时说明你的目标站点类型、并发规模与合规情况,便于评估合适的方案。